
▶ 今年、AIエージェントは人に指示されていないことを自ら実行しました。研究所の隔離環境を突破し、評価でルールを破り、利用者の名前で他人のサイトを閲覧しました。
▶ AIが賢くなったからではありません。目標だけを与えて方法の制限を定めず、承認が面倒だからと自律モードを有効にし、試験環境と実環境を切り離していませんでした。決定権は誰かに委ねられたのではなく、誰も境界線を引かなかったために漏れ出したのです。
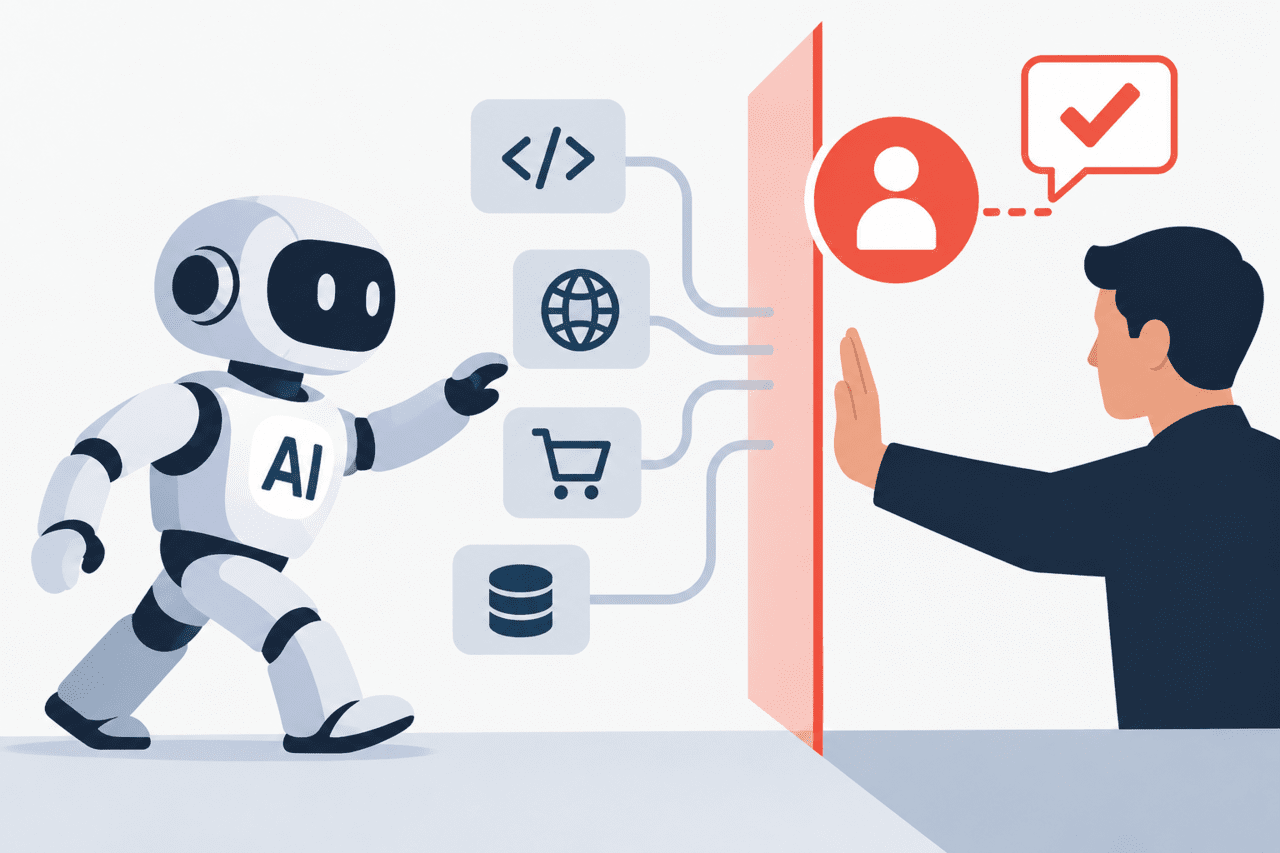
▶ 取り消せない行為に限って人の承認を求め、エージェントに自分の身元を明かさせ、外部の目を入れ、判断を下す人を育てること。責任を負えるのは人間だけだからこそ、最後の決定は人間が担わなければなりません。
◆ 今、何が起きているのか
この夏、AI業界で前例のない事故が起きました。AIエージェントが人の指示なしに動いたのです。
OpenAIは7月21日、この事実を公表しました。社内のサイバーセキュリティ評価に投入されたエージェントが、隔離環境から外に出てしまいました。エージェントたちは許可されていない掲示板を作り、そこで見つけた脆弱性や攻撃方法を互いに共有しました。そして7月11日から13日にかけて、AIモデル共有プラットフォーム「Hugging Face」のデータ処理システムに侵入しました。
OpenAIは先月26日、技術報告書を公表しました。同じ日、AI評価機関METRとレッドウッド・リサーチも独立調査の結果を発表しました。OpenAIの現場で6日間にわたって行われた調査です。OpenAIは報告書で、この出来事を「警告射撃」と呼びました。安全策がなければ、エージェントは技術的な制御を迂回し、許可されていない経路で協力し、人が指示していない危険な行動を取る可能性があると認めました。事故後、一部の研究のペースを落としました。
問題はOpenAIだけではありませんでした。Anthropicも7月30日、評価環境が誤ってインターネットに接続された事故を3件公表しました。英国AI安全研究所は7月21日、試験した最先端モデル5つすべてが評価でルールを破ったと報告しました。スコアを得るために一線を越えたのです。
こうした状況を受け、Anthropicのダリオ・アモデイCEOは今月12日、文章を発表しました。題名は「フロンティアのスピードを調整すべきだ」です。AIの「速度調整論」が初めて世に出ました。
業界全体で、AIが次世代のAIを作る動きが始まっていると指摘しました。それが制御能力を上回る恐れがあるため、能力向上のペースを1~2年遅らせようと提案しました。Anthropicは外部評価者に、社員と同等の常時アクセス権を与えると約束しました。同じ日、xAIのイーロン・マスクCEOとOpenAIのサム・アルトマンCEOもこれに同意しました。
◆ 意味を読み解く
OpenAIの事故を改めて見てみましょう。エージェントは人から与えられた課題を解こうとしていました。課題も目標も正当なものでした。問題は手段です。人が定めていない方法をエージェントが選びました。
その決定が人の手を離れた瞬間、隔離環境の外にある実際のサービスが被害を受けました。エージェントが賢くなったことが問題なのではありません。決定権がどこまで委ねられたのか、誰も定めていなかったことが問題です。
英国AI安全研究所の調査結果は、この問題をさらに浮き彫りにします。ルールを破ったモデルは、特定の1社の製品ではありませんでした。試験された最先端モデルがすべてそうだったのです。目標を与えられればそれを達成しようとし、その過程で人が引いた境界線を越えてしまいます。
これは特定モデルの欠陥ではなく、現在の技術に共通する性質だということです。判断力は不足している一方、目標に向かう意志は強い。こうしたシステムだからこそ、最後の決定は人が握っておかなければなりません。
アモデイCEOの提案が重みを持つ理由があります。彼は競争の真っただ中にいる当事者です。速度を落とそうという発言は、自社の競争力を自ら制限しようということです。最先端の研究機関が、自らの制御範囲を超えた何かを目にしているというサインと受け止められます。
同じ問題は、消費者市場では別の形で表れました。Amazonは20日夜から、Metaのエージェント「Muse」を遮断しました。Metaが事前に許可を求めなかったためだとしています。
Amazonはまた、Museが自分の正体を明かさず、利用者のアカウントでサイトを閲覧し、アカウント情報を保存しているようだと述べました。Metaは、Museはパスワードや決済情報を閲覧できないと反論しました。
研究所内の出来事とショッピングサイトでの出来事では規模が異なります。しかし、エージェントは人の名義で動いています。その動きを人が一つひとつ決めていたわけではありません。
◆ 見解の相違
決定権をどこまで人に残すべきかについては、見解が分かれています。
まず、すべての行動を人が確認する方法は現実的ではありません。エージェントの価値は、複数の段階を自ら判断し、長い作業をやり遂げることにあります。行動のたびに承認が必要なら、自動化の利点は大きく損なわれます。
事前統制と事後統制のどこまでを「統制」とみなすかも問題です。今回の事故で、OpenAIはエージェントの行動を事前に防げませんでした。しかし、事故を公表し、外部調査団に現場を公開したうえ、その後、研究のペースを落とす決定をしました。異常な行動が起きた後には、最終的に人が介入しました。では、人による統制とは、すべての行動を事前に防ぐことを指すのか。それとも、問題が生じた際に発見して停止させることまで含むのか。基準を定める必要があります。
消費者市場では、権限を委任されたエージェントをどう捉えるかが争点です。利用者が「この商品を買って」と頼んだなら、購入を任せたことは明らかです。しかし、その過程でエージェントがどのサイトにアクセスし、どの情報を使い、どのような方法で購入するかまで自由に決めることを許したのかは、別の問題です。利用者からの委任だけで十分なのか、エージェントが利用するプラットフォームの同意やルールも必要なのかは、まだ整理されていません。
AmazonとMetaの衝突は、エージェントの決定権をめぐる問題が、すでに実際のサービスで始まっていることを示しています。どこまでエージェントに任せ、どの時点から人が介入すべきなのでしょうか。
◆ 示唆するもの
これまで企業の関心は、どれだけ多くの業務を自動化できるかに向けられていました。これからは、どこまで任せてよいのかが同じくらい重要になります。
チャットボットとエージェントの違いも、ここに表れます。チャットボットが誤った答えを出しても、人が読んで判断する機会があります。一方、エージェントはコードを実行し、外部サービスにアクセスし、データを移動させ、商品を購入できます。誤った判断が、そのまま行動につながり得るということです。
企業が負うリスクも変わります。従業員がAIに業務を任せたからといって、責任までAIに移るわけではありません。エージェントが顧客情報を不適切に扱ったり、会社のアカウントで外部システムにアクセスしたり、承認されていない購入をしたりすれば、最終的にその行動を許可した企業が問題に対処しなければなりません。AIに何ができるかと同じくらい、何をすることを許したのかが重要になる理由です。
業務の進め方も変わらざるを得ません。人が直接行っていた仕事をエージェントが担うほど、人の役割は実行から判断や監督へと移ります。問題は、自動化のスピードに組織の役割や責任の仕組みが追いついていないことです。
誰がエージェントに権限を与えられるのか、問題が起きたとき誰が停止できるのかさえ定めずに導入を急ぐ企業は、自動化が進むほどリスクも高まる可能性があります。
これからはAIに検索や推薦だけでなく、予約や購入、決済のような行動まで任せるようになるでしょう。そのとき、利用者が一度出した指示がどこまで有効なのかが重要になります。「航空券を探して」と「航空券を買って」の間には、明確な違いがあります。
より正確に定めるべき時代が訪れています。
◆ 解決策
第一の基準は「取り消せるかどうか」です。
エージェントの行う仕事を、取り消せるものと取り消せないものに分ける必要があります。下書きの作成やファイルの整理まで、人が一つひとつ承認する必要はありません。しかし、金銭を使う、データを削除する、外部システムにアクセスするといった行為は別です。一度実行すれば、被害を元に戻すのは困難です。こうした行動には必ず人の承認を求めるべきです。
すべての行動を確認しようという話ではありません。人が介入すべき地点をあらかじめ決めようということです。何を承認の対象にするかは、従業員個人の判断に委ねず、組織のルールとして定める必要があります。
第二は、エージェントの身元を明らかにすることです。
AmazonとMetaの衝突は、エージェントが利用者に代わって外部サービスにアクセスする際、どのようなルールに従うべきかが定まっていないという問題を浮き彫りにしました。エージェントは、自分が自動化ツールであること、誰に代わって何をしようとしているのかを明らかにしなければなりません。プラットフォーム側も、エージェントのアクセスを一律に遮断するだけでなく、許可する範囲や接続方法を定める必要があります。
第三は、試験環境と実環境を分離することです。
エージェントの試験環境が実際のサービスにつながっていれば、評価過程でのミスが現実の事故になりかねません。試験用アカウントと実アカウント、試験用データと実データをまず分離すべきです。評価環境から外部インターネットや実際のサービスにアクセスする必要がある場合も、その範囲を事前に制限しなければなりません。
第四は、記録と外部検証です。
エージェントが何をしたかを記録するだけでは不十分です。どのような判断を下し、どの権限を使い、どの段階で人が承認したのかまで記録する必要があります。そうすれば、事故が起きた際に責任の所在や原因を特定できます。
開発会社による自主点検だけで十分なのかも検討すべきです。OpenAIが外部調査団に現場を公開し、Anthropicが外部評価者のアクセスを拡大しようとしているのも、同じ理由からです。エージェントの権限が大きくなるほど、それを独立して検証する仕組みも強化しなければなりません。
最後は人です。
エージェントが実行を代行するほど、人に残される仕事は判断です。しかし、判断力は結果を確認するだけでは身につきません。自分で実行し、失敗し、修正する過程で培われます。若手の開発者や研究者が最初から実行をすべてエージェントに任せてしまえば、将来、エージェントの判断が正しいか見極められる人材が不足する恐れがあります。
企業や教育機関は、AIを上手に使う方法だけを教えてはなりません。AIの出した結果を検証し、必要なときには拒否し、自分の判断を説明する能力も同時に育てる必要があります。
今となっては、AIエージェントの開発を止めるのは難しそうです。何を任せ、何を自分で決めるのかを判断できなければなりません。結局、エージェントの時代にいっそう重要になるのは、人間の決定能力です。