
<編集者注>ChatGPTに質問を入力すると、数秒で答えが返ってきます。レポートを要約し、外国語を翻訳し、複雑な問題も解いてくれます。今やAIは特別な技術ではなく、誰もが日常的に使うツールになりました。
IT記者として働く中で、新しい技術やAIのニュースに人より早く触れる機会がありました。2022年末にChatGPTが登場したときもそうでした。周囲に紹介しましたが、反応は冷ややかなものでした。
「それって何?」「AIは精度が低いじゃないか」「実用化されたら使ってみるよ」
それから4年近くがたちました。今では学生が課題にAIを活用し、会社員がレポート作成にChatGPTを使っています。企業は組織や仕事の進め方を変える「AIトランスフォーメーション(AX)」に乗り出しています。
ふと、こうしたAIがどのように作られているのか気になりました。スマートフォンの中ですべての計算が行われているわけではありません。私たちが送った質問はインターネットを経由してデータセンターに届きます。そこに設置されたサーバーには、NVIDIAのGPUや、SKハイニックス・サムスン電子などが生産するHBMが搭載されています。HBMはDRAMを複数層に積み重ねた高性能メモリーです。DRAMはシリコンウエハー上に作られます。
興味深いのは、ChatGPTが登場した当時、半導体市場が低迷期にあったことです。新型コロナウイルスの流行期間中にPCやスマートフォンの需要が鈍化し、メモリー半導体の価格が下落しました。サムスン電子とSKハイニックスも業績悪化に見舞われました。
しかし、生成AIが急速に普及すると状況は変わりました。データセンターへの投資が増え、AIの演算に必要なGPUとHBMの需要も急増しました。
SKグループの崔泰源(チェ・テウォン)会長は2024年11月、次世代ChatGPTの登場を受け、AI市場は2027年前後に大きく拡大する可能性が高いとの見通しを示しました。
AIはどのように巨大な半導体産業とつながっているのでしょうか。ChatGPTから出発し、半導体の原料である砂まで、さかのぼってみました。
1. AIサービス(私たちが毎日使うAI)
ChatGPT、GoogleのGemini、そしてAnthropicのClaudeは、代表的な生成AIサービスです。
ユーザーが質問を入力すると、AIモデルが内容を処理して回答を生成します。文章を書いたり、外国語を翻訳したりすることもできます。画像や動画を作成するAIサービスもあります。
私たちが見るチャット画面ですべてのAI演算が行われているわけではありません。質問を入力すると、インターネットを通じてサーバーに送られます。サーバー上でAIモデルが回答を生成し、その結果がユーザーに返されます。
もちろん、一部のAI機能はスマートフォンやPCでも実行できます。しかし、大規模な生成AIサービスでは、主にデータセンターで演算処理が行われます。
2. AI企業(AIモデルを作るのは誰か)
ChatGPTを作ったのは米国のOpenAIです。GoogleはGeminiを開発し、AnthropicはClaudeを開発しました。Metaや中国のAI企業も独自のモデルを開発しています。
AI企業は膨大なデータを使ってモデルを学習させます。その後、ユーザーが質問すると、学習済みのモデルが回答を生成します。
この過程は大きく、学習と推論に分けられます。学習(Training)とは、AIがデータからパターンを習得する過程です。推論(Inference)は、学習を終えたモデルが質問に答えたり、新たな結果を作り出したりする過程です。私たちがAIに質問して答えを受け取る作業は、主に推論に当たります。
学習にも推論にも多くの計算が必要です。特に大規模なAIモデルを開発するには、膨大な演算能力が求められます。AI企業がデータセンターや高性能半導体の確保に巨額の資金を投じるのはそのためです。
3. データセンター(AIが実際に動く場所)
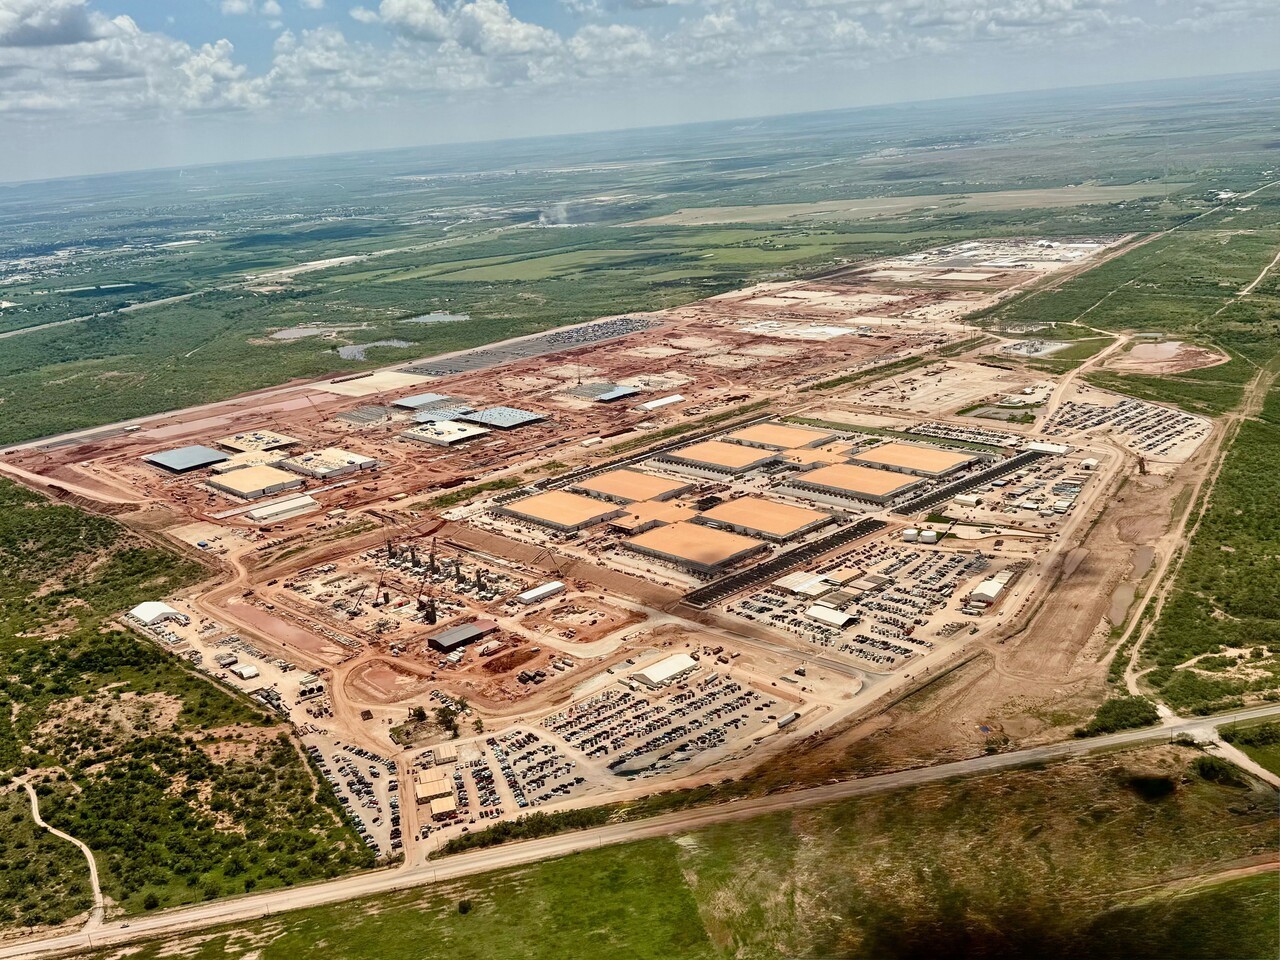
データセンターは、多数のサーバーを集めて運用する施設です。外から見ると大きな建物です。内部にはサーバーを設置したラックが並び、電力供給設備や熱を冷やす冷却設備も備わっています。
AI企業はデータセンターでモデルを学習させ、サービスを運用します。自社のデータセンターを利用するほか、クラウド企業から演算リソースを借りることもあります。
大規模なAIモデルを学習させるには、多数の半導体を同時に稼働させなければなりません。サービスの運用にも、多くのユーザーからのリクエストを処理する演算能力が必要です。
課題となるのは電力と熱です。高性能半導体が稼働するほど電力消費は増え、熱も多く発生します。冷却設備が重要なのはそのためです。
AI市場が拡大するにつれ、データセンターの建設だけでなく、電力の確保や冷却技術も重要な課題として浮上しています。
4. サーバー(AIを動かすコンピューター)
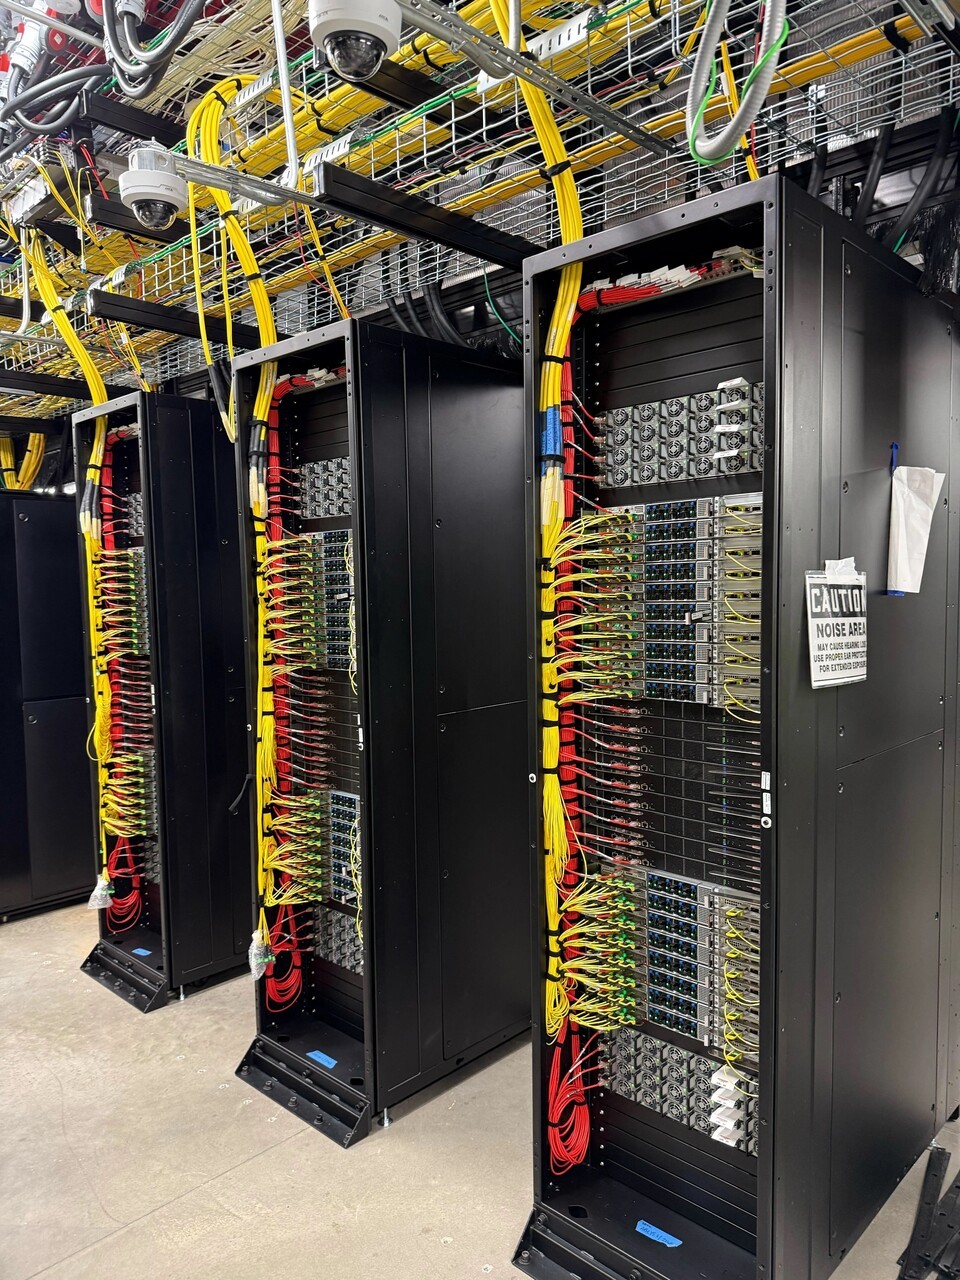
サーバーも基本的にはコンピューターです。私たちが使うPCと同じように、演算を処理し、データを保存します。違いは用途と規模です。
個人用コンピューターが一人の利用を中心に動くのに対し、サーバーは多くのユーザーからのリクエストを処理できるよう設計されています。
サーバーにはCPUとメモリー、ストレージが搭載されています。AI演算用のサーバーでは、GPUなどのアクセラレーターも使われます。CPUはコンピューター全体を管理し、さまざまな命令を処理します。AIアクセラレーターは、大規模な計算を高速で行う役割を担います。
複数のサーバーを接続すれば、より大きなAIモデルを学習させたり、多数のユーザーからのリクエストを同時に処理したりできます。ただし、すべてのAIアクセラレーターが一般的なサーバーに搭載されるわけではありません。GoogleのTPUのように、専用システムに複数のチップを接続して使う場合もあります。
AIシステムで重要なのは、どれだけ多くの計算を速く処理できるかという点です。ここでGPUとTPUが登場します。
5. GPUとTPU(AI演算を担う半導体)
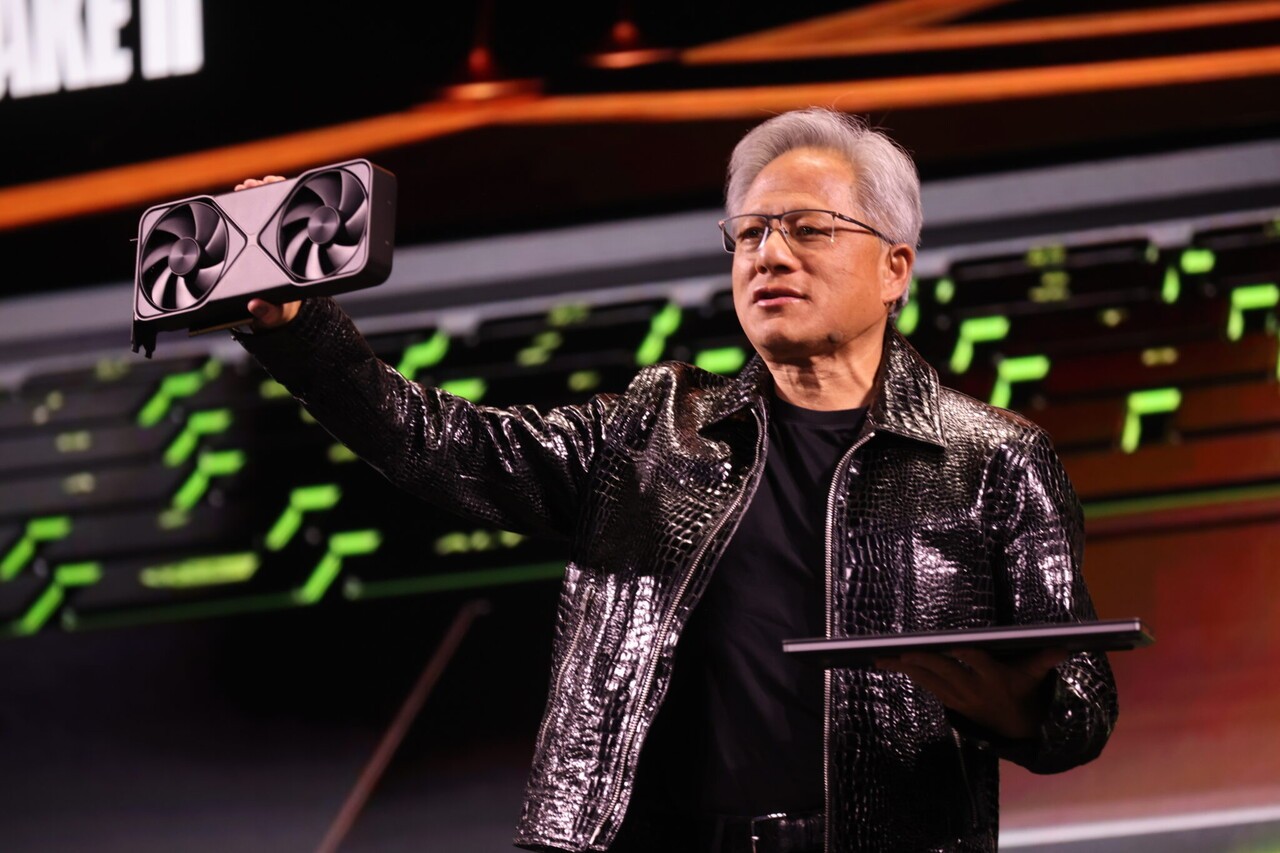
AIを動かすには、膨大な量の計算が必要です。この処理を高速で行う半導体をAIアクセラレーターと呼びます。
代表的な製品がNVIDIAのGPUとGoogleのTPUです。GPUはGraphics Processing Unit(グラフィックス処理装置)の略です。もともとはゲームや映像に必要なグラフィックスを処理するために発展しました。多数の計算を同時に実行する能力に優れており、AIの学習や推論にも広く使われています。
NVIDIAはGPUをAI演算に活用できるよう進化させました。関連ソフトウェアやシステムも併せて提供し、AI半導体市場で強い地位を築いています。
Googleは別の道を選びました。AI演算に特化したTPUを独自に開発したのです。TPUはTensor Processing Unit(テンソル処理装置)の略です。AIモデルで繰り返される大規模な行列計算を高速で処理できるよう設計された半導体です。Googleは自社のAIサービスやクラウドインフラにTPUを活用しています。
GPUとTPUは設計目的や構造が異なります。GPUはグラフィックスからAIまで幅広い演算に活用されます。一方、TPUは機械学習に必要な計算に特化しています。
共通点もあります。どちらも大量のデータを高速で処理しなければなりません。演算速度がどれほど速くても、必要なデータを適時に受け取れなければ、性能を十分に発揮できません。そこで登場するのがHBMです。
6. HBM(AIアクセラレーターにデータを供給するメモリー)
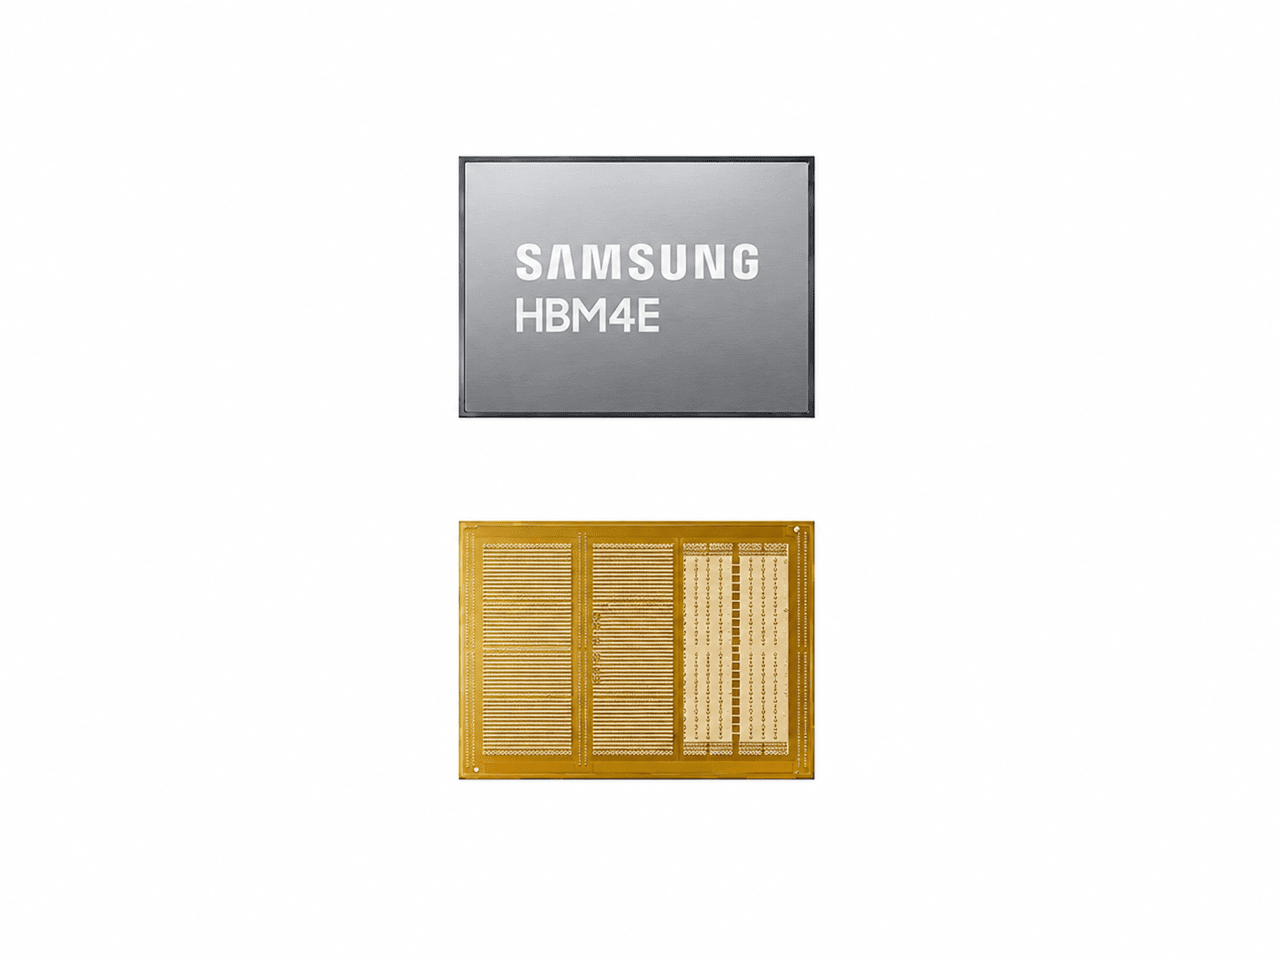
HBMはHigh Bandwidth Memory(広帯域メモリー)の略です。簡単に言えば、大量のデータを一度に高速で伝送できるよう設計されたメモリーです。
AIにメモリーが必要なのはなぜでしょうか。GPUやTPUが計算を担うのに対し、メモリーは計算に必要なデータを保持します。AIモデルを構成する膨大な数値や、演算中に生成されるデータもメモリーに保存されます。AIアクセラレーターはそのデータを読み込んで計算し、結果を再びメモリーに書き込みます。
課題は速度です。AIアクセラレーターは短時間に膨大なデータを処理します。メモリーがデータを適時に供給できなければ、演算装置は待たなければなりません。どれほど高速なGPUを使っても、性能を十分に発揮できないということです。
HBMはこうした問題を減らすために開発されました。複数のDRAMチップを垂直に積み重ね、チップ同士を接続します。これにより、大量のデータを同時にやり取りできます。
HBMは先端パッケージング技術によって、GPUなどのAIアクセラレーターの近くに配置されます。データの移動距離を短くし、高い帯域幅を確保するためです。GoogleのTPUも製品によってはHBMを使用しています。
SKハイニックス、サムスン電子、米マイクロンが代表的なHBMメーカーです。生成AIの普及に伴い、HBMの需要も大きく伸びました。
7. DRAM(HBMを作る基本の半導体)
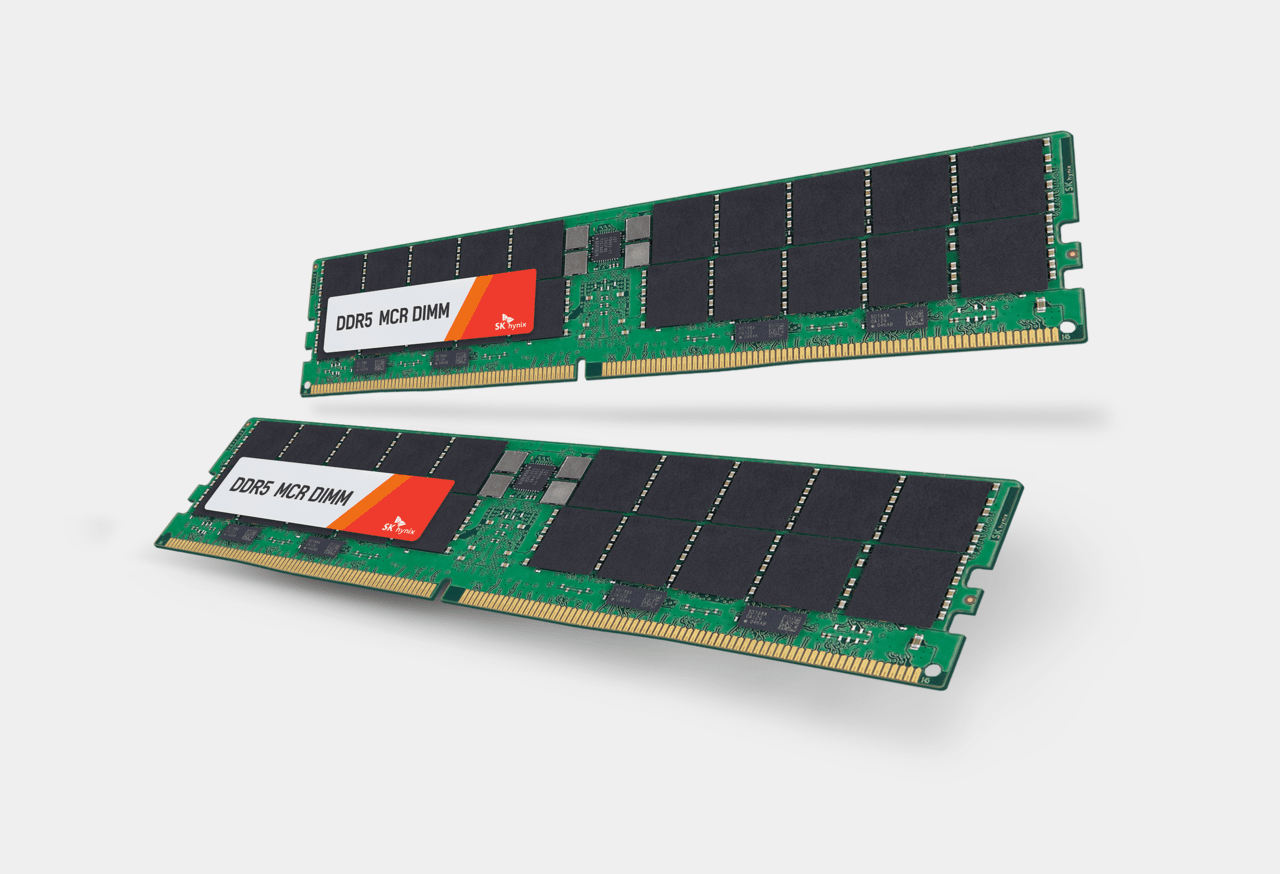
DRAMはDynamic Random Access Memory(ダイナミック・ランダム・アクセス・メモリー)の略です。
コンピューターが作業している間、必要なデータを一時的に保存する半導体です。文書作成やプログラムの実行にもDRAMが使われます。
DRAMは電源が切れると、保存していたデータが消えます。写真やファイルを長期間保存するストレージとは役割が異なります。
HBMも基本的にはDRAMの技術を活用しています。複数のDRAMチップを垂直に積み重ね、微細な接続経路を通じてデータをやり取りできるようにします。このとき活用される代表的な技術がTSVです。
TSVはThrough-Silicon Via(シリコン貫通電極)の略です。シリコンチップを垂直に貫通する電気的な接続経路です。この技術を使えば、積み重ねたメモリーチップの間でデータを高速に伝送できます。
DRAMはどのように作られるのでしょうか。DRAMも半導体の一種です。まず、丸く薄い板の上に多数の回路を作ります。その後、検査を経て小さなチップに切り分けます。このとき使う丸い板がウエハーです。
8. ウエハー(半導体を作る丸い板)
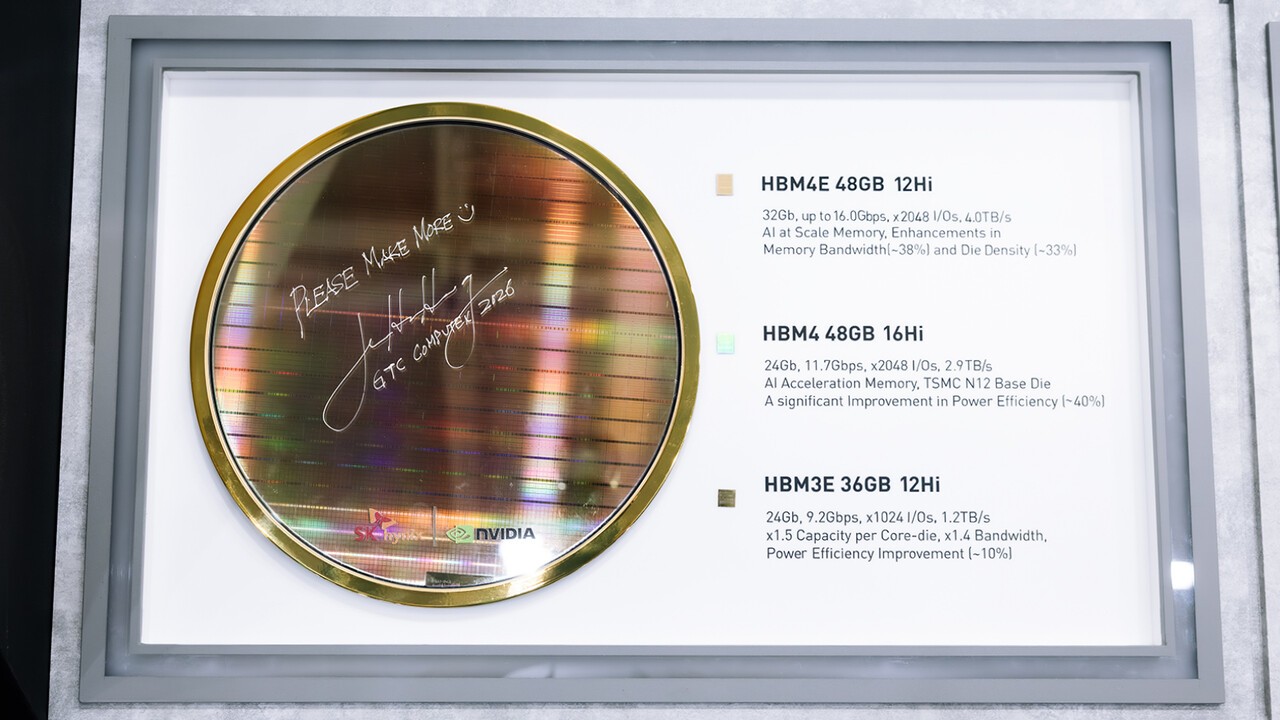
半導体工場の写真でよく見かける、丸くて薄い板がウエハー(Wafer)です。
DRAMをはじめとする半導体は、このウエハー上に微細な回路を刻んで作ります。一枚のウエハーから複数の半導体チップを製造できます。
ウエハーの主な材料はシリコン(Silicon)です。日本語ではケイ素と呼ばれ、元素記号はSiです。半導体に使うシリコンは、微細な不純物まで取り除いて高純度に精製します。
精製したシリコンを薄い円盤に加工した後、回路を形成します。その後、検査と切断を経て個々のチップに分け、パッケージングします。ウエハーを作るシリコンはどこから得られるのでしょうか。
9. 砂と石英(半導体の原料までさかのぼる)
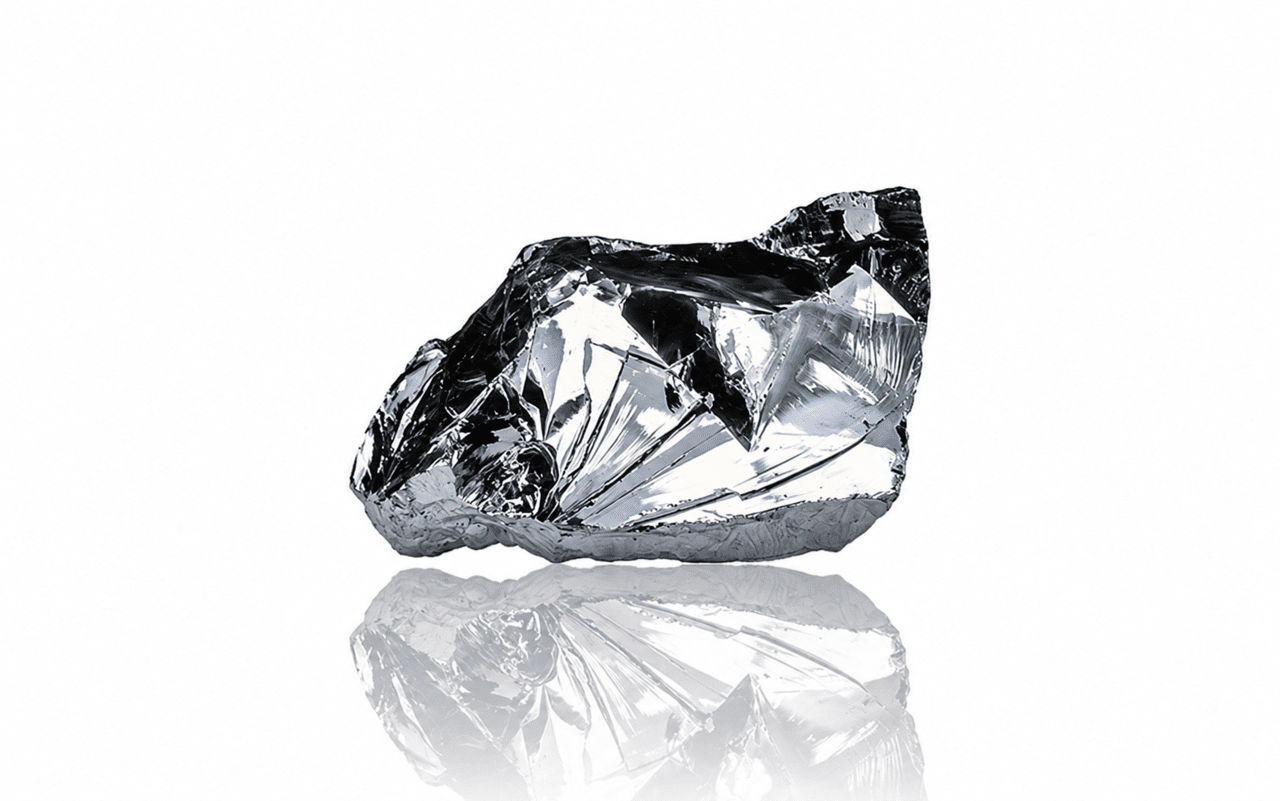
シリコンは比較的ありふれた元素です。砂や石英には二酸化ケイ素(SiO₂)が含まれています。二酸化ケイ素はケイ素と酸素が結びついた物質です。半導体産業では主に、高純度の石英など適した原料からシリコンを得ます。
まず原料を加工してシリコンを生産します。その後、不純物を取り除き、半導体製造に必要な高い純度に精製します。精製したシリコンから単結晶を成長させ、薄く切り出してウエハーを作ります。
このウエハー上にDRAMが作られます。DRAMを複数層積み重ねるとHBMになります。HBMはGPUやTPUなどのAIアクセラレーターにデータを供給します。
AIアクセラレーターはデータセンターでモデルを学習させ、回答を生成するために使われます。その結果が、私たちの使うAIサービスにつながります。
もちろん、浜辺の砂をすくって、そのまま半導体を作れるわけではありません。半導体用シリコンには、厳格な精製と製造工程が必要です。
最後に。AIが変えた半導体産業
生成AIの普及は、半導体市場の需要構造を変えています。PCとスマートフォンが中心だったメモリー半導体市場で、AIが新たな成長エンジンとして浮上しました。
AIモデルの高度化に伴い、GPUやTPUなどのAIアクセラレーターの需要が増えています。大規模な演算に必要なデータを高速で供給するHBMも、重要な半導体として定着しました。
AI産業の成長は、半導体だけでなく、サーバーやネットワーク機器、電力・冷却インフラへの投資にもつながっています。AIサービスの拡大が、関連産業全体に影響を及ぼしているのです。
今回の記事が、身近でありながら難しく感じられていたAIと半導体を理解するうえで、少しでも役立てばと思います。