
マイクロソフト(MS)は先週、世界各地で発生したOutlookおよびMicrosoft 365の大規模障害について、原因を明らかにした。7月に配布したサーバー修正コードに潜在的な欠陥があり、ネットワークトラフィックの増加とサーバー容量の減少が重なって、連鎖的な障害が発生したことが分かった。
MSでCopilot、エージェント、プラットフォームを担当するチャールズ・ラマナ上級副社長は16日(現地時間)、自身のXアカウントで、12日に発生した障害の原因と復旧の経緯を説明し、正式に謝罪した。「すべてのお客様にご迷惑をおかけしたことを深くお詫びし、通常の業務や運営に影響が及んだことを認識している」と述べた。
今回の障害により、Outlookのメールや予定表をはじめ、Microsoft 365のサービスに支障が生じた。政府機関や裁判所、病院、学校、企業などでも通信障害が報告された。MSは今回の事故で悪意ある活動は確認されていないと明らかにした。
◆ 7月に配布した修正コードに潜在的な欠陥
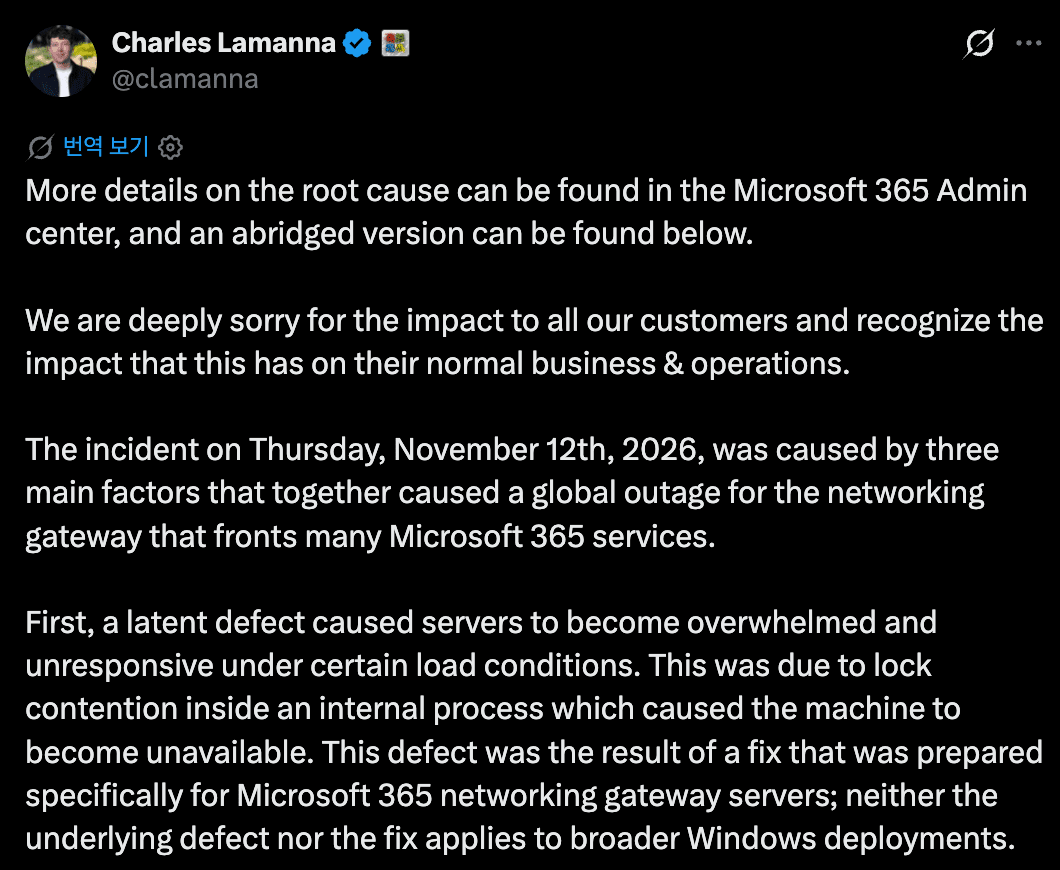
MSでCopilot、エージェント、プラットフォームを担当するチャールズ・ラマナ上級副社長は16日(現地時間)、Xを通じて12日に発生したMicrosoft 365の大規模障害について謝罪し、原因を公表した。MSによると、7月に配布した修正コードに潜在的な欠陥があり、サーバー負荷の増加と利用可能な容量の減少が重なって、世界規模のサービス障害が発生した。(写真=チャールズ・ラマナ氏のX投稿)
MSによると、障害はMicrosoft 365サービスの前段で利用者からのリクエストを処理するネットワークゲートウェイサーバーで始まった。ゲートウェイは外部からの接続リクエストを受け付け、OutlookやTeamsなど各サービスに接続する役割を担う。
問題のコードは、7月にゲートウェイサーバー専用として配布された修正に含まれていた。MSは数週間かけて世界各地のサーバーに段階的に適用し、その後3カ月以上、特段の異常を確認していなかった。
このコードには、特定の負荷条件下でサーバー内部の処理が同じリソースを確保しようと待ち続ける「ロック競合」の欠陥があった。競合が激しくなるとリクエスト処理が遅れ、サーバーが応答しなくなる可能性がある。
事前の負荷試験でも欠陥は見つからなかった。MSは、試験環境で使用したサーバーの仕様やトラフィック構成が実際の運用環境とは異なっていたと説明した。特にロック競合は処理コア数の多い新しいサーバーで深刻化する傾向があったが、従来の試験は比較的コア数の少ない旧型機器を中心に行われていた。
ラマナ上級副社長は、この欠陥と修正コードはMicrosoft 365のゲートウェイサーバーにのみ適用され、一般的なWindowsオペレーティングシステムの配布環境には該当しないと説明した。
◆ Teamsのトラフィック移行とサーバー容量の減少が重なる
潜在的な欠陥が実際の障害につながったきっかけは、サーバー負荷の増加と利用可能な容量の減少だった。
MSはMicrosoft 365の運用にあたり、異なる2つのネットワークゲートウェイ体制を維持している。一方に問題が発生した場合、もう一方のゲートウェイにサービスを切り替え、障害の影響を抑える設計になっている。
障害発生の約15時間前、Teamsのトラフィックが代替ゲートウェイからメインゲートウェイに切り替えられた。メインゲートウェイは、Outlookのメールサービスを支えるExchange Onlineも処理していた。Teamsのトラフィックが加わったことでサーバー負荷が増し、リクエストの処理状況も変化した。
当時、ゲートウェイサーバーの容量の約14%は、前日に発生した別の問題により稼働を停止していた。MSは定期点検と復旧作業を通じて容量を正常化しており、容量の減少だけでサービスに影響が出る水準ではなかったと説明した。
トラフィックの増加とサーバー容量の減少が重なり、7月の修正コードに含まれていた欠陥が表面化した。利用者のリクエストが滞留し始め、サーバーは応答しなくなった。障害は米国内でサービスの利用が集中する時間帯に発生した。
その後、自動トラフィック迂回機能が障害の拡大につながった。MSのシステムはサーバーとの接続が切れると、利用者のリクエストを正常なサーバーへ自動的に切り替える。今回は、障害が発生したサーバーから移されたリクエストが残りのサーバーに集中し、同じ欠陥が連続して発生した。
MSによると、最初の障害発生から2時間以内に、問題はゲートウェイサーバー全体へと拡大した。障害が最も深刻だった時点では、全ゲートウェイサーバーの80%以上が応答しなくなった。
◆ 障害の拡大を防ぐ隔離措置も機能せず
MSはネットワークゲートウェイを数千単位の容量区画に分け、地域ごとに管理している。特定の区画で問題が起きても、ほかの区画に広がらないように分離した構造だ。
今回の事故では、別の問題により、区画間の障害拡大を防ぐ隔離措置が本来の役割を果たせなかった。サーバーから始まった連鎖的な障害は地域ごとの境界を越え、世界中のゲートウェイインフラに拡大した。
サービスによって復旧時期にも差が生じた。Teams、OneDrive、SharePoint、Officeアプリは、問題が発生したゲートウェイから別の経路に切り替えられたため、比較的早く復旧した。Teamsのチャットや会議機能は、障害が続いた時間の大半で正常に動作していた。
一方、Exchange Onlineは該当のゲートウェイから別の経路に切り替えられず、メールサービスの障害がより長く続いた。
◆ MS「最終報告書を今週公開」
復旧作業中にも問題が続いた。エンジニアがサーバーを再起動すると、処理されなかった利用者のリクエストが一度に押し寄せ、サーバーが再び応答しなくなった。
従来の自動復旧手順は、このように広範囲のサーバーが同時に応答を停止する状況を想定して設計されていなかった。欠陥を含むコードも数カ月前に配布されていたため、一般的な変更の取り消し手順や機能制御の方法では、迅速に元へ戻すことが難しかった。
MSは原因を特定した後、問題が発生したコードの実行経路を以前の正常な状態に戻す更新プログラムを開発した。その後、一定規模のサーバーを段階的にサービスから切り離し、修正を適用して再起動したうえで、運用環境に戻した。一部の作業では、ある地域のサーバー容量の半分以上を対象に復旧手順を実施した。
MSは今回の事故に関する詳細をMicrosoft 365管理センターに掲載し、最終的な事故検証報告書を今週中に公開する予定だ。